Strata 与 Qwen:在游戏电脑上跑 1250 亿参数的 Qwen 模型
开源推理引擎 Strata 是什么、如何把 Qwen3.8-Flash-Next 塞进 12 GB 显存、作者公布的速度数据,以及安装前需要了解的取舍。
最近在社交媒体上看到的 “Strata Qwen”,指的是 GitHub 上的开源推理引擎 Strata(Niko1221/Strata)。它的卖点很直接:在一台普通游戏电脑上运行 Qwen3.8-Flash-Next,这是一个 1250 亿参数的混合专家(MoE)语言模型,并提供一键安装和本地 API。
本文整理项目自己公开的信息,帮你判断它是否值得占用那几十 GB 的硬盘。需要说明的是,Strata 是语言模型(可选图片输入)的运行时,与我们工作室基于 Qwen Image 2.1 的图像生成没有关系。
Strata 是什么
根据 README,Strata 是一个面向 Windows 和 Linux 的本地推理引擎,采用 MIT 许可证。安装程序(Windows 上是 START-HERE.bat,Linux 上是 ./setup.sh)会检测显卡、推荐合适的模型尺寸、下载权重,并在 http://127.0.0.1:8080 启动服务。启动后你可以使用:
- 本地浏览器聊天界面;
/v1的 OpenAI 兼容 API,以及/v1/messages的 Anthropic 兼容接口;- 面向编程助手的 MCP 服务器;
- 可选的图片输入、实时 GPU/CPU/内存监控面板、可调推理强度和多 GPU 支持。
除主模型外,项目还提供专家数量约减半的 “Coder” 版本,对内存的要求更低。
1250 亿参数如何塞进 12 GB 显存
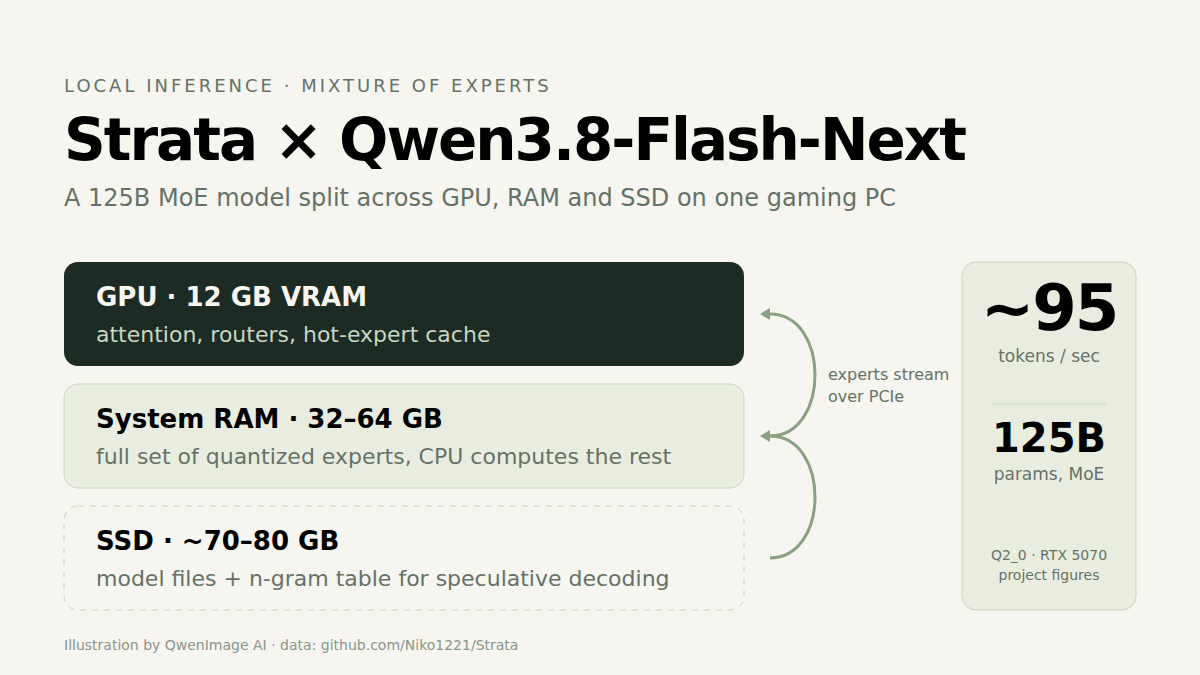
MoE 模型每生成一个 token 只会激活少量专家,Strata 正是利用了这一点。项目的技术说明描述了三层存储结构:
- GPU 存放注意力层、路由器,以及一个自适应的高频专家缓存。文档提到,每多 1 GB 显存大约能多缓存 700 个专家。
- 系统内存 存放全部量化后的专家,GPU 未缓存的专家由 CPU 并行计算。
- SSD 存放模型文件和用于投机解码的 n-gram 表。
另外两项技术贡献很大:专家权重延迟反量化,并按块通过 PCIe 流式传到 GPU;模型自带的多 token 预测层每次验证可以起草约 2.4 到 3.2 个 token。
公布的速度
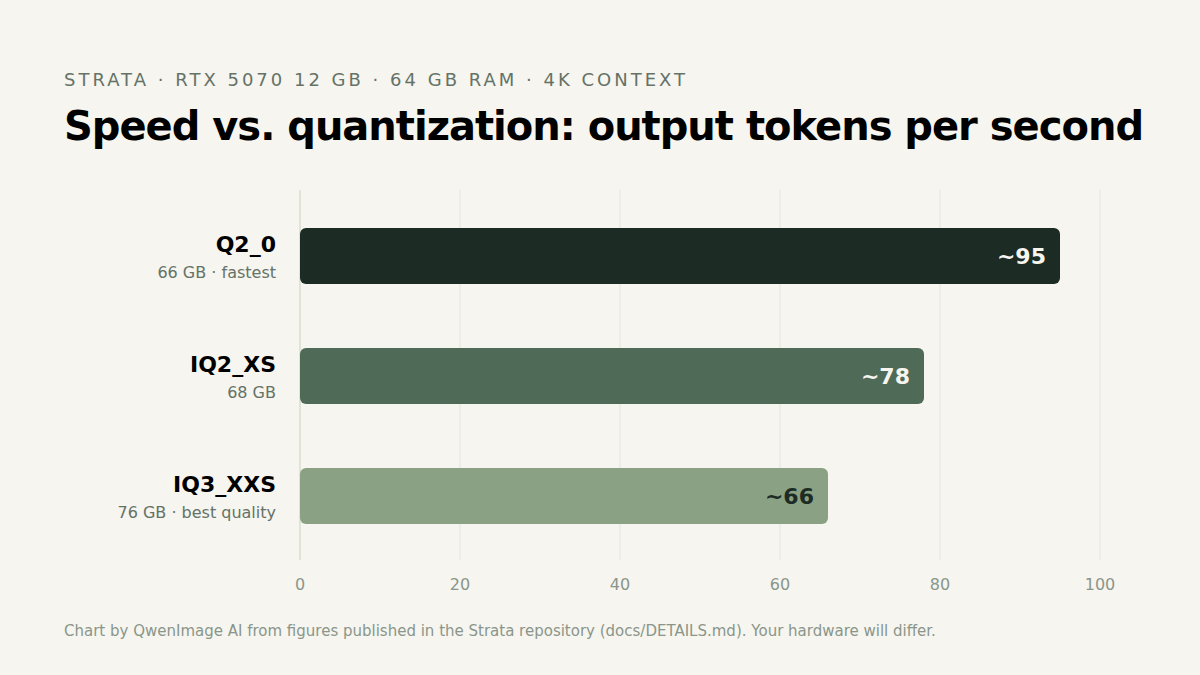
上图使用仓库中公布的数据,测试环境为 RTX 5070(12 GB)、64 GB 内存、4K 上下文:
- Q2_0(约 66 GB):约 95 tokens/s,速度最快。
- IQ2_XS(约 68 GB):约 78 tokens/s。
- IQ3_XXS(约 76 GB):约 66 tokens/s,三者中保真度最高。
上下文越长速度越低:文档给出 Q2_0 在 262K 满上下文时约为 56 tokens/s。note.com 上的一篇独立实测(RTX 5070 + Ryzen 5 7600 + 64 GB 内存)得到相近结果:Q2_0 短上下文约 93 tokens/s,128K 上下文约 74 tokens/s。这些数字应视为同类机器上的理想值,PCIe 带宽、内存速度和 CPU 都会影响实际表现。
硬件要求
项目列出的要求如下:
- NVIDIA RTX 显卡,至少 12 GB 显存(README 也提到 AMD Radeon RX 7900/9000 系列);
- 推荐 64 GB 内存;README 给出的最低值是 32 GB,技术文档中较小量化包的最低值是 48 GB;
- 70 到 80 GB 的 SSD 可用空间;
- 较新的驱动(文档写明 NVIDIA 580 以上)和支持 AVX2 的 x86-64 CPU。
需要权衡的地方
- 质量。 这些是对超大模型做的 2 bit 和 3 bit 量化。作者也承认它与官方全精度模型存在差距;IQ3 版本能缩小差距,但速度更慢。
- 一次只处理一个请求。 服务按顺序处理请求,更适合个人使用,而不是多人共享。
- 首次加载慢。 README 提醒加载模型时电脑可能卡住 1 到 3 分钟;很长的首条提示词大约每 3 万 token 需要 1 分钟处理。
- 平台差异。 AMD 显卡的图片输入目前只支持 Linux。
我们的看法
Strata 很好地展示了 MoE 稀疏性、专家缓存和激进量化能把本地推理推到多远。如果你有一张 12 GB 显卡、64 GB 内存和 80 GB 空闲 SSD,它是获得私有、OpenAI 兼容、背后是超大 Qwen 模型的本地接口的实用方式。项目更新很快,安装前请先到仓库确认最新要求。
如果你来这里是为了图像而不是文字,可以在 QwenImage AI 工作室试试 Qwen Image 2.1 的提示词。